Transcreva entrevistas sem enviar seu áudio pra nuvem.
Transcritório é um aplicativo de desktop para transcrição automática e separação de falantes em português brasileiro. Roda 100% na sua máquina — sem login, sem assinatura, sem envio de dados.
Windows
Windows 10/11 · 64-bitv0.2.8 Instalador de 1 clique (ou 3 comandos) macOS
Apple Silicon e Intelv0.2.8 Via Homebrew — sem Gatekeeper Linux
x86_64v0.2.8 3 comandos no terminal Ainda avaliando? Role a página e veja em 30 segundos por que pesquisadores estão migrando de serviços na nuvem.
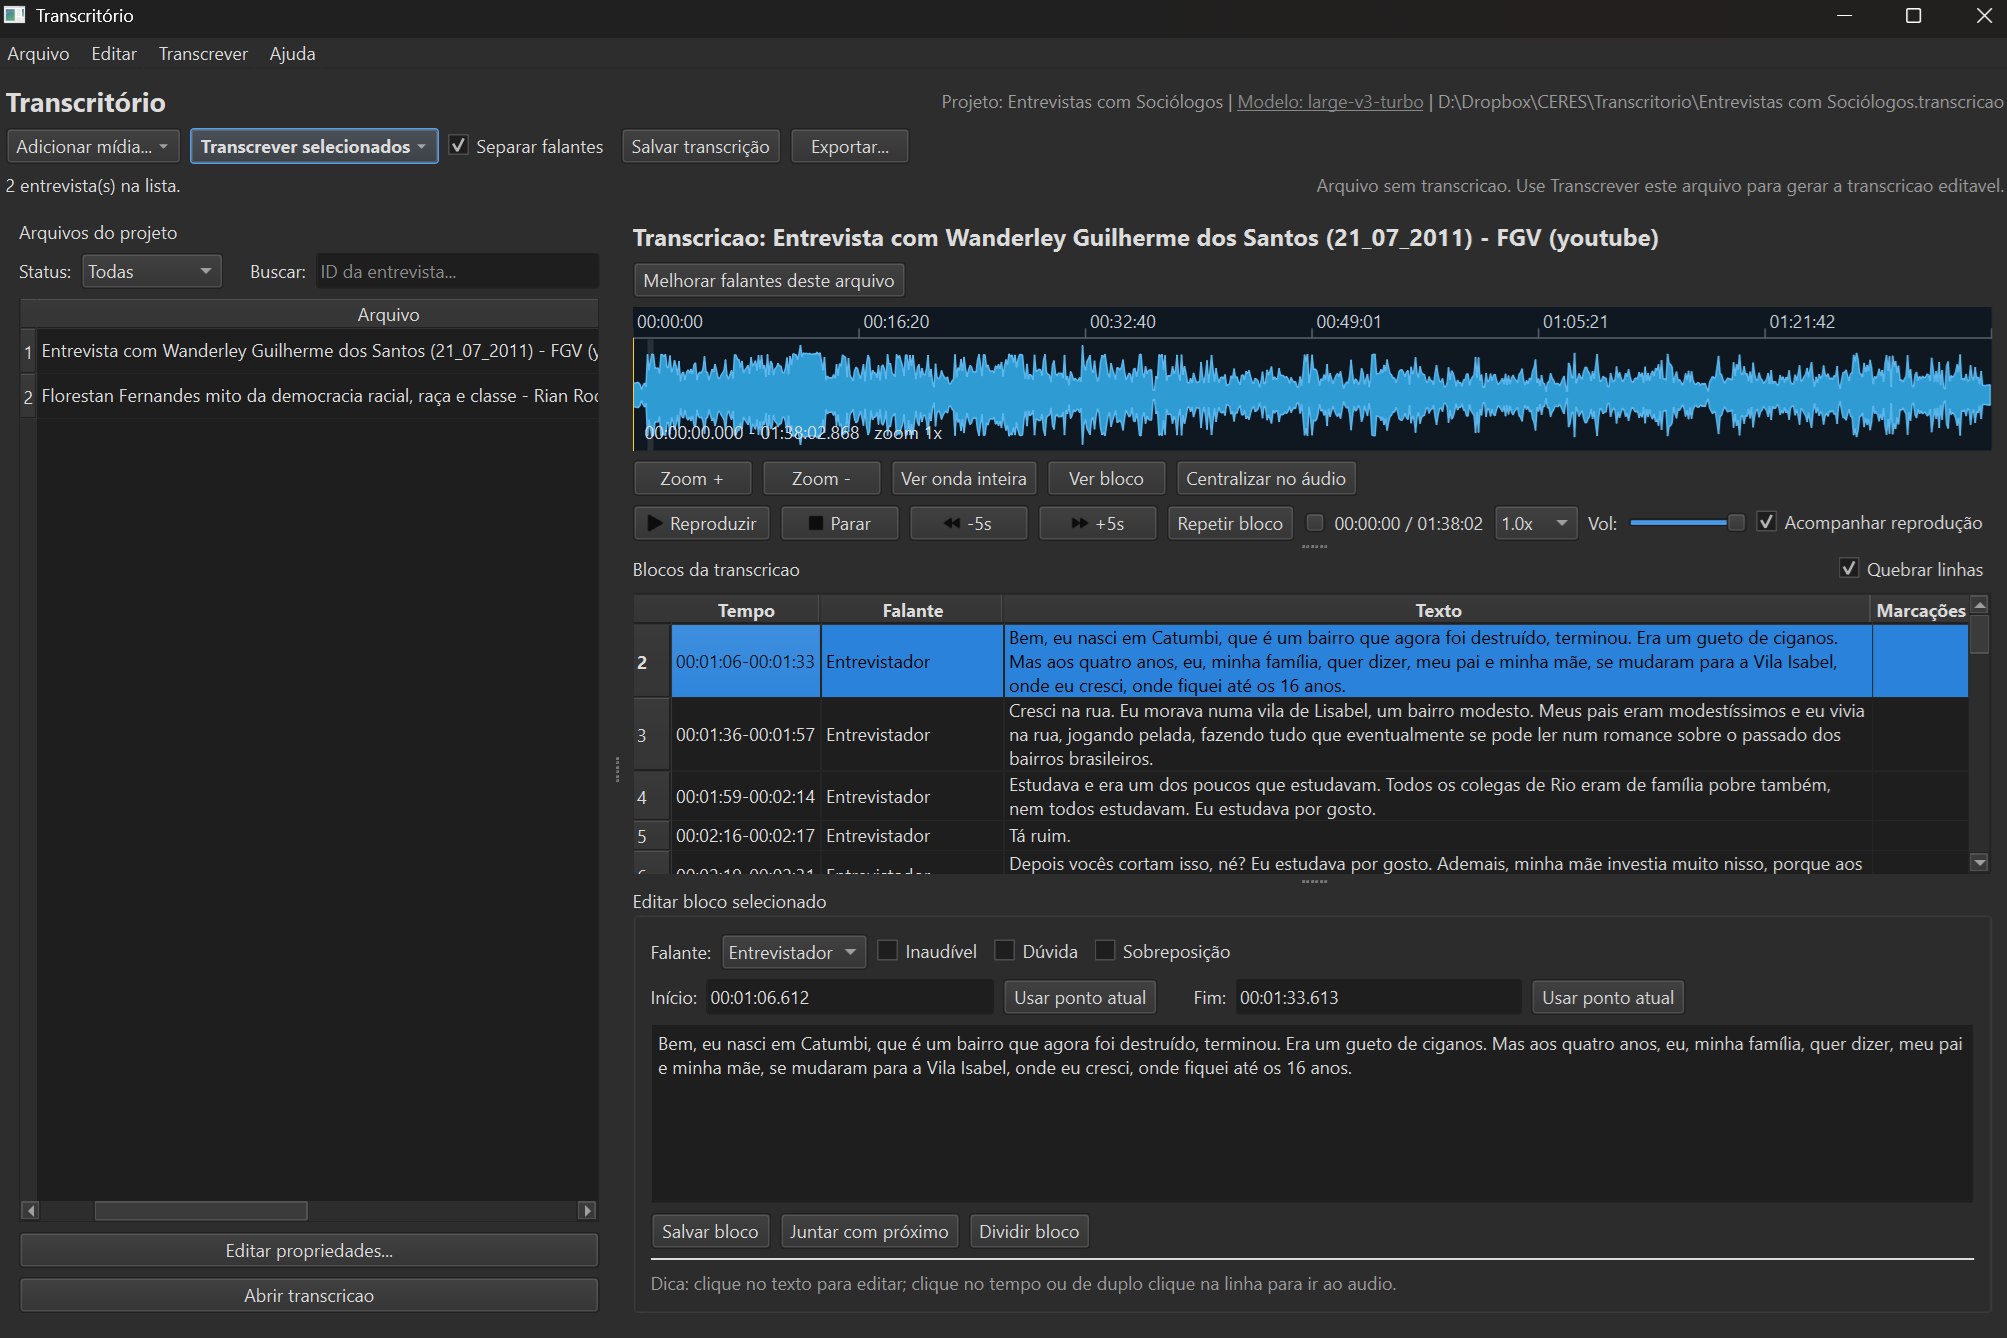
- 100% local, sem nuvem
- Separação automática de falantes
- Português brasileiro nativo
- Editor com forma de onda
- Resumo, glossário e busca com AI local
- Trocas de falante conferidas no áudio
- Exporta em vários formatos
- Gratuito e código aberto
Como mudam as suas horas de trabalho
Sem Transcritório
- 8 a 10 horas transcrevendo manualmente 1 hora de entrevista.
- Enviar áudio sigiloso para servidores de empresas estrangeiras.
- Mensalidade de R$ 100–300 por serviços de transcrição online.
- Marcar falantes na mão, linha por linha.
- Explicar ao comitê de ética por que o áudio foi para a nuvem.
Com Transcritório
- Minutos de processamento com GPU (ou com o motor TAGARELA), depois só revisar.
- Áudio nunca sai do seu computador.
- Zero custo, para sempre. Código aberto sob licença MIT.
- Falantes identificados automaticamente e renomeáveis em um clique.
- Texto pronto para colar no projeto de pesquisa (logo abaixo).
Privacidade por desenho, não por promessa
- Processamento 100% local: o áudio da entrevista nunca é enviado a servidores externos.
- Sem coleta de dados, sem telemetria: nenhum cadastro ou login é exigido.
- Código-fonte aberto sob licença MIT: auditável por qualquer pessoa.
- Compatível com LGPD e TCLE: você mantém controle integral sobre o áudio do informante.
Tudo que um pesquisador precisa
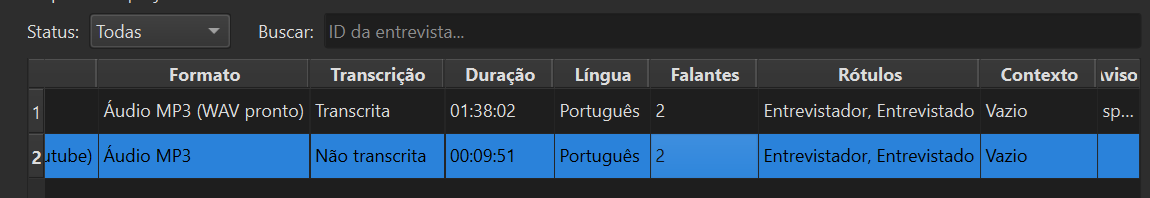
Gerenciador de arquivos do projeto
Todos os áudios do projeto em uma única tela, com status visual de cada etapa: ainda não transcrito, em fila, concluído, revisado. Você acompanha um projeto inteiro — dezenas de entrevistas — sem perder o fio do trabalho.
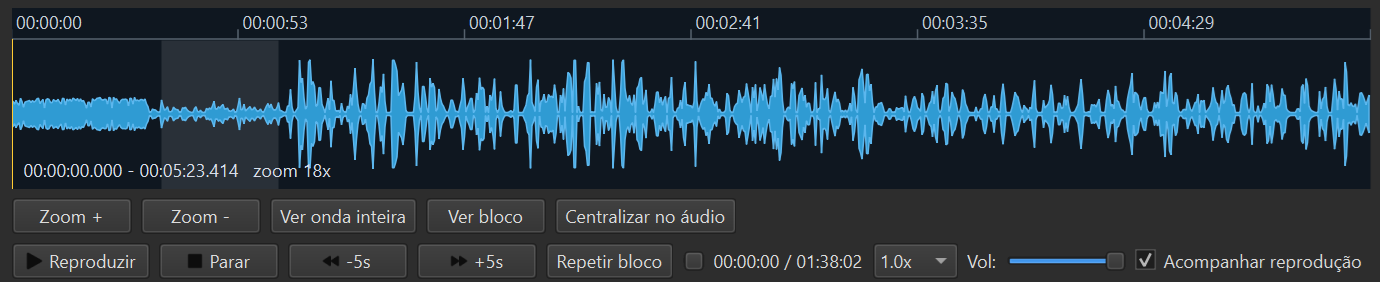
Revisão lado a lado com o áudio
Ouça e corrija ao mesmo tempo. Cada trecho transcrito fica ancorado no ponto exato do áudio, e um clique leva você até lá. O pesquisador revisa em um terço do tempo que levaria em um editor de texto comum.
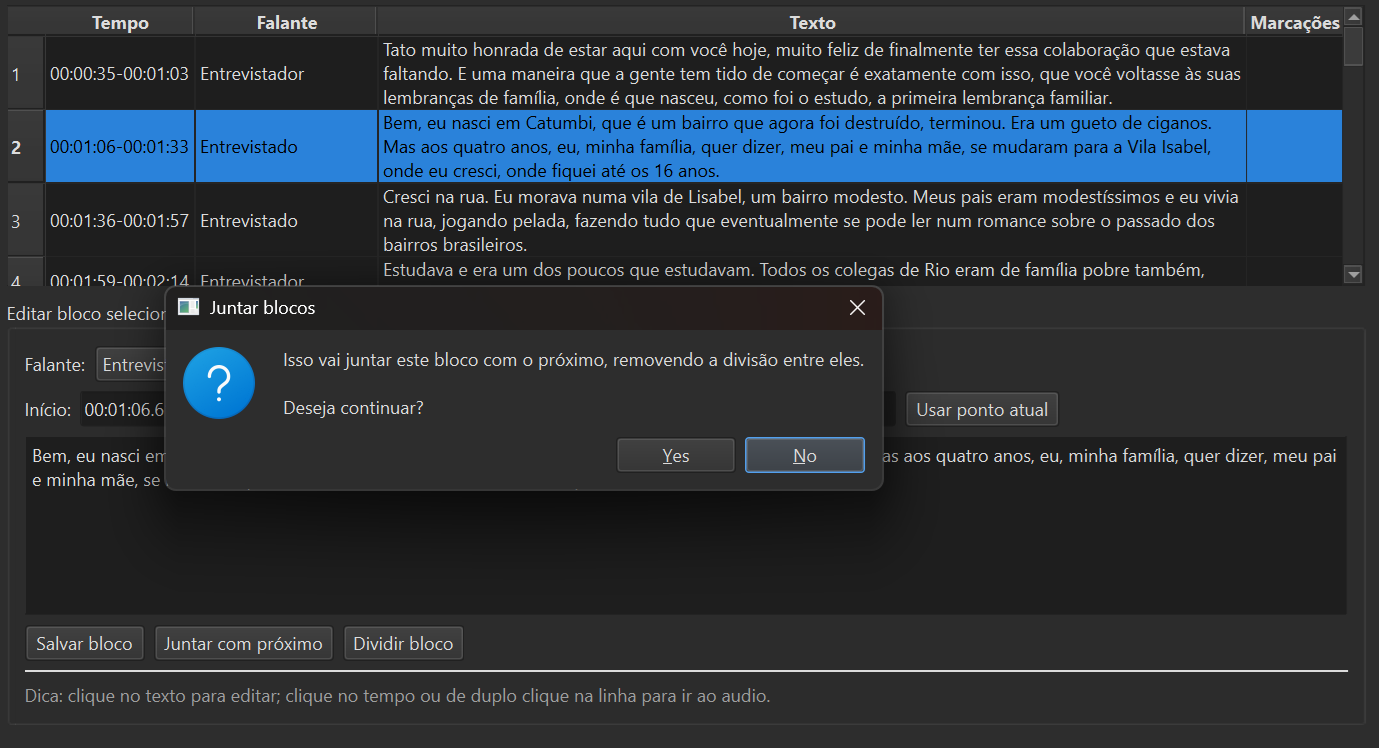
Editor de turnos com forma de onda
A forma de onda mostra visualmente silêncios, sobreposições e trocas de falante. Você ajusta limites de trechos, junta ou divide blocos com um clique — útil em entrevistas com falas rápidas ou interrupções frequentes.
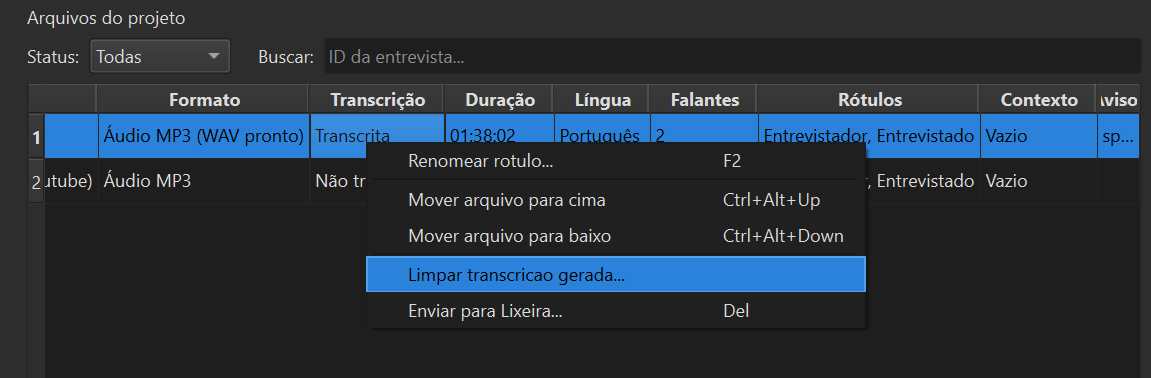
Tabela de turnos pronta para análise
A transcrição é organizada em turnos de fala com metadados de tempo e falante. Exporte em DOCX, MD, SRT, VTT, CSV, TSV ou NVivo — e importe direto no NVivo, Atlas.ti, MAXQDA ou em um script de R/Python.
E a versão 0.2 trouxe um estúdio de análise inteiro:
- ✨ Resumo com índice temático — a AI local lê a entrevista revisada e devolve um resumo estruturado com os temas e onde eles aparecem. Nada sai do seu computador.
- ✨ Glossário de nomes + revisão de grafias — a AI varre o projeto inteiro atrás de pessoas, lugares e instituições citadas, agrupa as variações de grafia ("Joao", "João", "Jono") e abre uma revisão em que você decide, ocorrência por ocorrência — com a grafia certa editável e um clique para ouvir o trecho antes de decidir.
- ✨ Buscar por sentido e perguntar — escreva uma pergunta em português ("o que os entrevistados dizem sobre a escola?") e receba os trechos das entrevistas que tratam disso, mesmo sem as palavras exatas. Isso funciona em qualquer computador. Havendo placa NVIDIA, a AI também escreve uma resposta citando os trechos.
- 🔍 Verificação acústica das trocas de falante — depois da separação de vozes, o app confere cada troca contra o próprio áudio e marca as duvidosas no ponto exato, com navegação direta entre as marcações.
- Dois motores de transcrição — o Parakeet pt-BR "TAGARELA" (da NVIDIA, treinado para o português falado; o padrão em todas as máquinas — 1h de áudio em poucos minutos, mesmo só no processador) e o Whisper (a reserva para outros idiomas). Gravações em 15 outros idiomas também transcrevem com tempos por palavra (16 pacotes de alinhamento, incluindo o português).
- Aba Documentos — tudo que o app produz (transcrição final, legendas, resumo, glossário, versões anteriores) numa aba só, com data e botão de abrir. Chega de caçar arquivo em pasta.
Como usar, em quatro passos
- 1
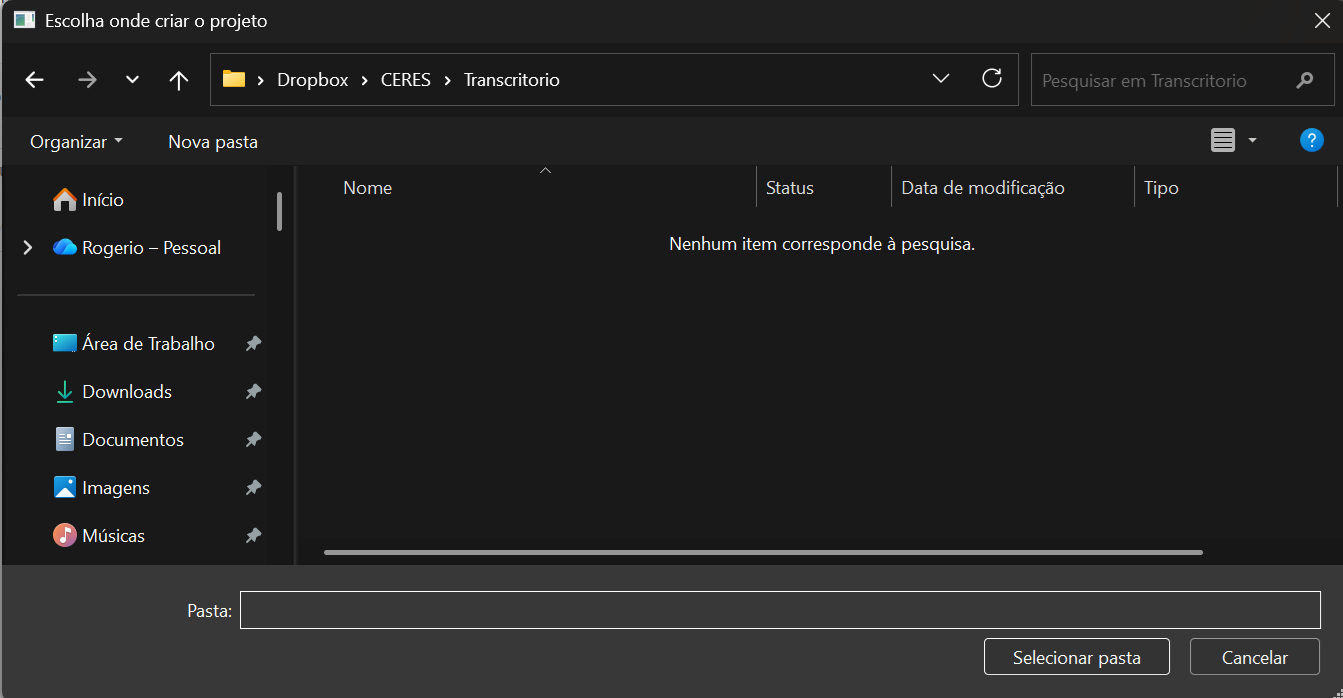
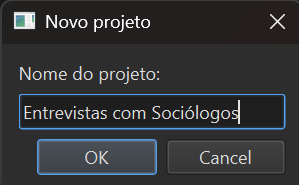
Crie um projeto
Escolha um nome para o projeto e uma pasta onde os arquivos serão organizados. O Transcritório cria a estrutura de pastas para você.
- 2
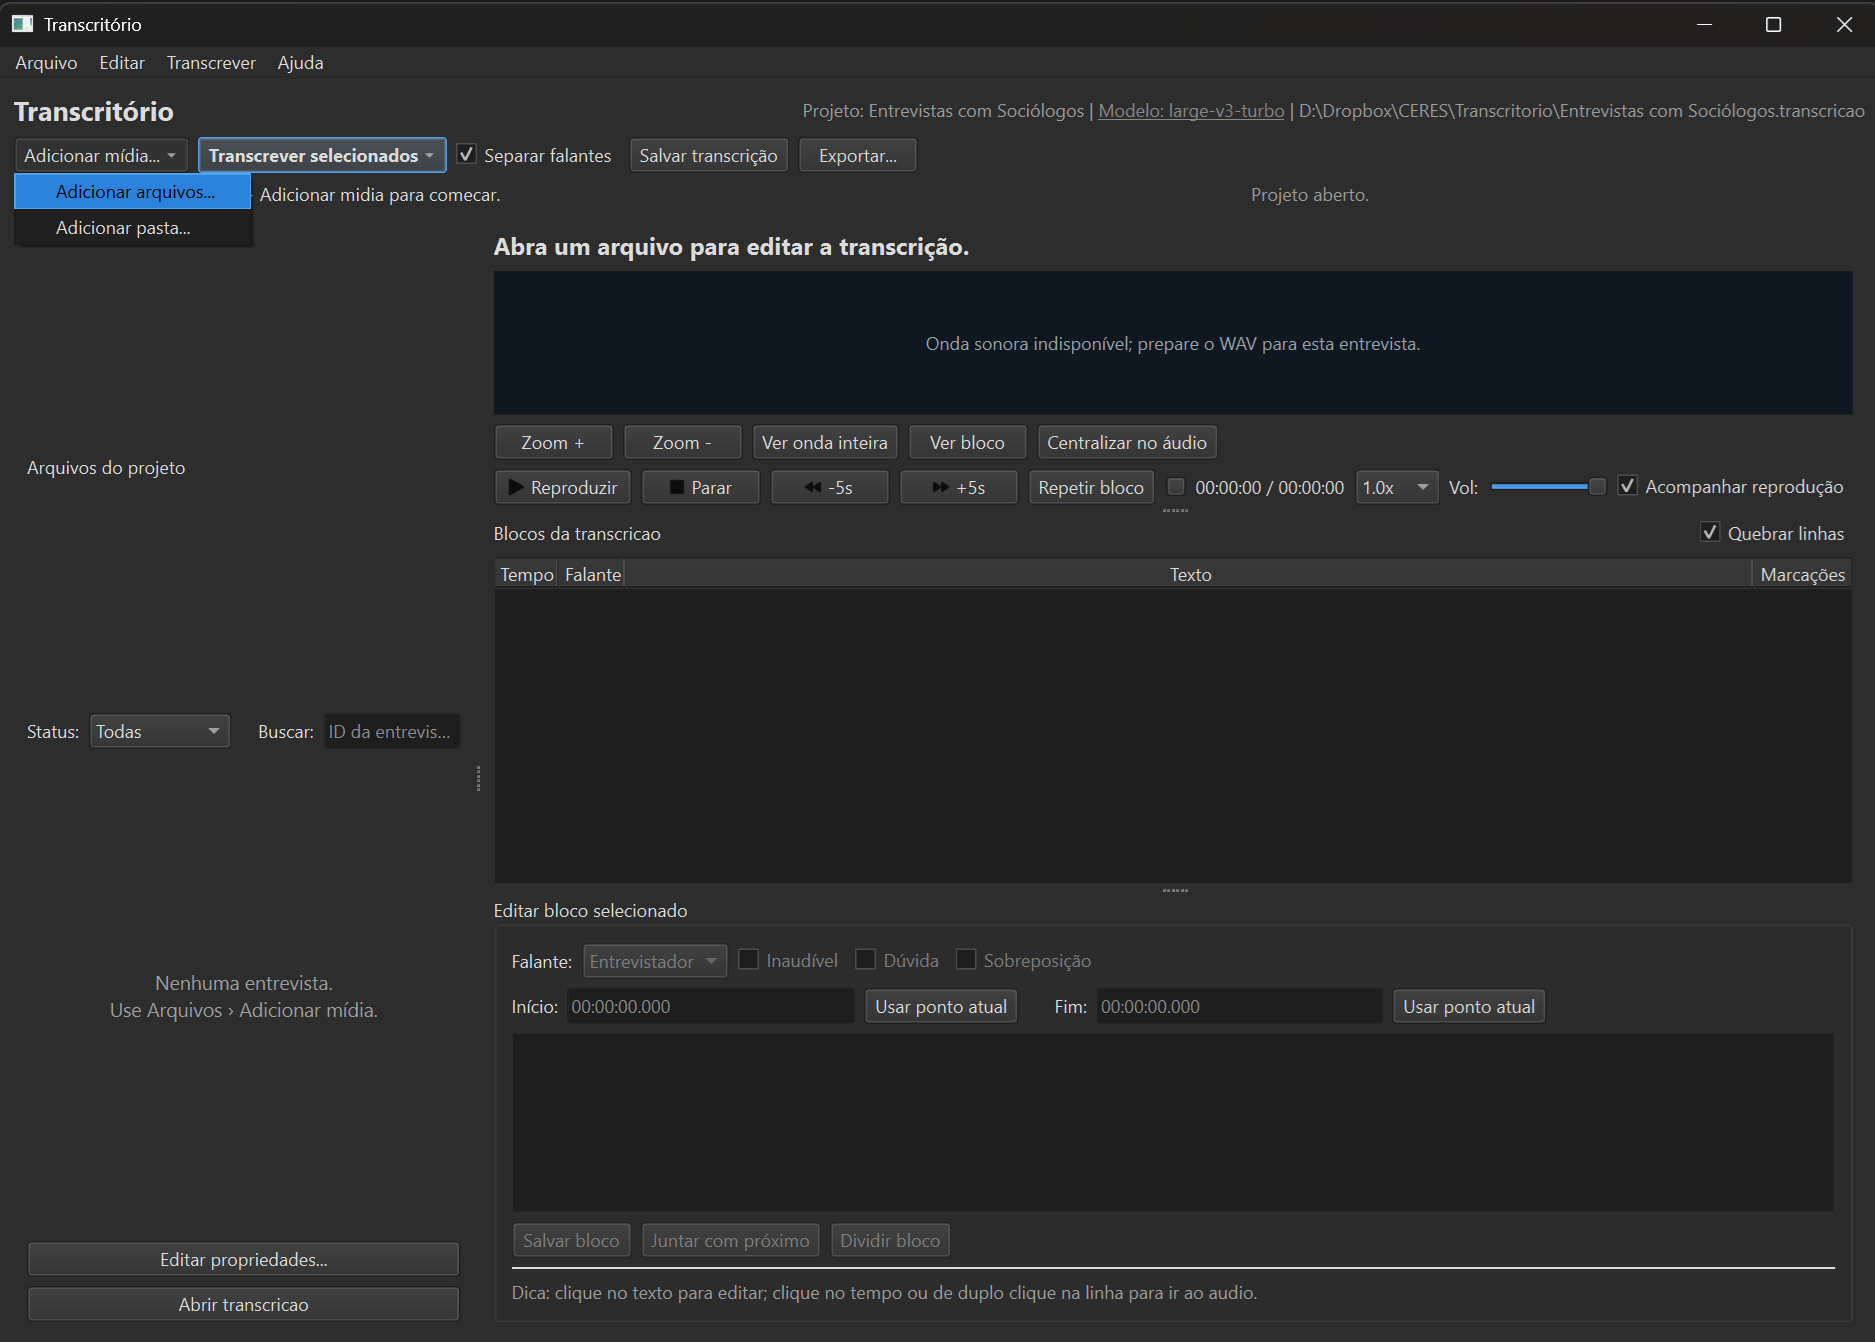
Adicione os áudios ou vídeos
Arraste seus arquivos para a janela. MP3, WAV, M4A, MP4 e outros formatos comuns são aceitos.
- 3
Clique em transcrever
O Transcritório pergunta quantas pessoas falam (entrevista a dois? grupo focal?) e faz o resto. Os tempos estão nos cartões de requisitos abaixo: poucos minutos com o motor TAGARELA (o padrão), com ou sem placa de vídeo; cerca da própria duração do áudio se optar pelo Whisper em CPU.
- 4
Revise no Estúdio e exporte
Ao abrir a transcrição, o Transcritório toca uma amostra de cada voz e pergunta de quem é — os nomes (Entrevistadora, Joana, Pedro…) valem para a transcrição inteira. Depois é ajustar trechos e exportar no formato da sua preferência.
Revisar é onde as horas vão — e o Estúdio foi desenhado para funcionar sem tirar as mãos do teclado. O capítulo do manual sobre o Estúdio de Revisão ensina o ciclo inteiro.
Instalando no seu sistema
Os instaladores antigos (.exe/.dmg/AppImage) foram descontinuados: sem assinatura de código comercial, eram bloqueados por antivírus em muitas máquinas. O formato atual usa apenas componentes assinados pelos distribuidores oficiais (Microsoft, Astral, PyPI) — sem alertas de segurança e sem senha de administrador.
🪟 Windows 10/11
Sem terminal (recomendado): baixe Instalar-Transcritorio.bat e clique duas vezes nele. Ele instala tudo sozinho, mostra o progresso e abre o programa no final — se o Windows perguntar "Deseja executar este arquivo?", confirme (o script é público e auditável; só instala de fontes oficiais). Para atualizar depois: Atualizar-Transcritorio.bat.
Ou, pelo Prompt de Comando (menu Iniciar → cmd → Enter):
- Instale as ferramentas de base:
winget install astral-sh.uve depoiswinget install Gyan.FFmpeg. - Feche e abra o Prompt de Comando de novo, e instale o Transcritório:
uv tool install --python 3.12 transcritorio - Abra com o comando
transcritorio— um atalho é criado na área de trabalho no primeiro uso. - Opcional (placa NVIDIA): para transcrever até 9x mais rápido, use no aplicativo o menu Ferramentas → Instalar aceleração NVIDIA (CUDA)…, que mostra o comando pronto (download de ~2,5 GB).
🍎 macOS
- No Terminal (com Homebrew):
brew install uv ffmpeg - Instale o Transcritório:
uv tool install --python 3.12 transcritorio - Apple Silicon (M1/M2/M3/M4): use
uv tool install --python 3.12 "transcritorio[mac]"para transcrever com aceleração Metal (seloMotor: MLX (Metal)). - Abra com o comando
transcritorio. Sem Gatekeeper: não há app para "autorizar" — o programa roda no seu perfil de usuário.
🐧 Linux
- No terminal:
curl -LsSf https://astral.sh/uv/install.sh | shesudo apt install ffmpeg(Ubuntu/Debian; use o gerenciador da sua distribuição). - Feche e abra o terminal de novo, e instale:
uv tool install --python 3.12 transcritorio - Abra com o comando
transcritorio. - Opcional (placa NVIDIA): menu Ferramentas → Instalar aceleração NVIDIA (CUDA)… dentro do aplicativo (download de ~2,5 GB).
Suporte principal: Windows 10/11. macOS e Linux funcionam pelo mesmo canal, mas ainda sem teste de campo — se algo falhar, abra uma issue. Para atualizar: uv tool upgrade transcritorio (ou o Atualizar-Transcritorio.bat). Para desinstalar: uv tool uninstall transcritorio — projetos e transcrições ficam intactos.
Versão de teste beta 0.3.0b1
Existe uma versão de teste, para quem quiser experimentar o que vem a seguir e ajudar a encontrar problemas. Ela não substitui a versão estável: instala-se ao lado dela, e as duas podem ficar abertas ao mesmo tempo — a janela da versão de teste diz isso no título.
Novidades em teste: a busca por sentido foi refeita (a precisão dos 5 primeiros resultados subiu de 0,48 para 0,67 num gabarito julgado à mão) e virou um gesto só, “Buscar por sentido e perguntar” — os trechos em segundos, em qualquer computador, e a resposta escrita citando-os onde houver placa NVIDIA. Uma função nova de Temas das entrevistas agrupa os trechos de todas as entrevistas por semelhança de sentido, permite codificar (um ou mais códigos por trecho, ou todos os temas de uma vez) e exportar para o QualiLab ou para planilha. Em entrevistas e grupos focais, o programa pergunta quais falantes entram na análise — normalmente não se codifica quem pergunta. O Estúdio de Transcrição ganhou atalhos de teclado para o ciclo inteiro de revisão (ouvir, voltar, corrigir, juntar, seguir) e o botão “Juntar com anterior”.
Baixar Instalar-Beta.bat Windows — clique duas vezes. Reaproveita os modelos que você já baixou.
É uma versão para testar: pode ter defeitos, e a exportação para o QualiLab ainda não foi validada abrindo o arquivo no QualiLab de verdade. Seus projetos e transcrições não são alterados. Para remover, apague a pasta %LOCALAPPDATA%\Transcritorio\beta-venv. Notas completas · Relatar um problema
Requisitos, por tipo de instalação
O assistente de primeiro uso examina a sua máquina e sugere o perfil adequado — nada é imposto. Números medidos; tempos em CPU de 8 núcleos (em 4 núcleos, conte aproximadamente o dobro).
- Só transcrever (modelo compacto)
- Máquina: 2+ núcleos, 4 GB RAM
- Disco: ~6 GB
- 1h de áudio em poucos minutos com o motor TAGARELA (o padrão); ~1h se optar pelo Whisper.
- + separação de falantes e tempos por palavra
- Máquina: 4+ núcleos, 8 GB RAM
- Disco: ~7,5 GB (CPU) / ~10 GB (com GPU NVIDIA)
- Transcrição em minutos (TAGARELA); a separação de falantes leva de ~4 min (máquina de 24 threads) a ~22 min (4 threads) por hora de áudio em CPU — e pode ficar para depois; cerca de 1 min por hora com GPU NVIDIA de 4 GB+.
- + análise com AI local (resumo, glossário, perguntar)
- Máquina: GPU NVIDIA 6 GB+ VRAM, 16 GB RAM
- Disco: ~20 GB
- 1h de áudio em 5–10 min; análises em segundos a minutos.
A inteligência artificial por detrás
(detalhes técnicos)
Quando você clica em Transcrever, um pipeline de várias etapas roda inteiro no seu computador: o FFmpeg prepara o áudio (16 kHz, mono); o motor de transcrição converte a fala em texto com marcação de tempo palavra a palavra; o pyannote descobre quem fala em cada trecho; uma verificação acústica própria do Transcritório compara cada troca de falante com o próprio áudio e marca as duvidosas; e o texto vira blocos editáveis no Estúdio. As análises (✨) usam um segundo cérebro, também local. Cada peça abaixo foi escolhida em testes comparativos com entrevistas reais — e o conjunto é vigiado por mais de cem testes automáticos.
Whisper (OpenAI) via WhisperX e faster-whisper
Modelo de transcrição treinado em 680 mil horas de áudio multilíngue, com muito português. É a reserva para gravações em outros idiomas — o Transcritório sugere large-v3-turbo com GPU e small em CPU, e avisa sobre a diferença de qualidade — executada via faster-whisper (CTranslate2), com o alinhamento palavra a palavra do WhisperX. Em Apple Silicon, o mesmo Whisper roda no Metal via mlx-whisper.
Parakeet pt-BR "TAGARELA" (NVIDIA)
Motor treinado especificamente para o português brasileiro — e, desde a v0.2.5, o padrão em todas as máquinas (segundo os autores do modelo, em fala espontânea erra menos palavras que o Whisper large-v3). Rodando via onnx-asr, transcreve de 13× a 25× mais rápido que o tempo real mesmo sem placa de vídeo — 1 hora de entrevista em poucos minutos num notebook comum, com pontuação e tempos por palavra nativos. Só transcreve português: para outros idiomas o app avisa e oferece um Whisper de reserva.
pyannote.audio (separação de falantes)
Redes neurais que agrupam vozes semelhantes ao longo da entrevista para dizer quem falou em cada trecho — bem até 6–8 participantes. Por cima dela, a verificação acústica do Transcritório compara as vozes dos dois lados de cada troca e marca com 🔍 as trocas suspeitas, no ponto exato do áudio.
Modelos de análise local ✨
Cada tarefa usa o modelo próprio para ela, e não um só para tudo. A busca por sentido e os temas usam um encoder de recuperação (multilingual-e5) mais um reordenador opcional (bge-reranker) — modelos pequenos, que rodam em qualquer computador, inclusive sem placa de vídeo. O glossário de nomes usa o GLiNER, especializado em achar pessoas, lugares e instituições no texto, também no processador. Só o que precisa escrever — o resumo com índice temático, a resposta citando os trechos e os nomes dos temas — usa um modelo de linguagem (Qwen) num ambiente dedicado do app, e esse exige placa NVIDIA. Tudo offline — suas entrevistas nunca viram "dados de treinamento" de ninguém.
Processamento 100% local
Todo o conjunto roda sobre PyTorch, com interface em Qt e instalação gerenciada pelo uv. Nenhum áudio, texto ou metadado sai da sua máquina em momento algum. O primeiro uso baixa os modelos do perfil escolhido (uma vez só); depois, o aplicativo funciona sem internet.
Perguntas frequentes
Preciso de internet para usar?
Apenas na instalação e no primeiro uso, para baixar o programa (~2,5 GB) e os modelos do perfil escolhido (de ~3,5 GB no Essencial a ~5 GB no Padrão; a análise com AI do perfil Completo soma mais ~10 GB). Depois disso, o Transcritório funciona integralmente offline — nenhum áudio sai da sua máquina em momento algum.
Quão precisa é a transcrição?
Em áudios limpos de português brasileiro, a acurácia fica entre 90% e 96% das palavras corretas. Revisão humana continua sendo recomendada, especialmente para termos técnicos, nomes próprios e trechos com ruído.
E entrevistas com sotaque nordestino, caipira ou sulista?
O modelo Whisper large-v3 foi treinado com ampla variação dialetal em português e lida bem com sotaques regionais brasileiros. A queda de acurácia costuma ser pequena (2–4 pontos percentuais) em comparação a áudios em variante paulistana/carioca padrão.
Minha TI institucional bloqueia instalação de programas. O que faço?
A instalação não exige privilégios de administrador: o uv instala o Transcritório dentro do seu perfil de usuário, e não há executável baixado de site — justamente o que costumava disparar bloqueios de antivírus no formato antigo. Se ainda assim algo for barrado, peça à TI uma exceção apresentando a licença MIT e o repositório público no GitHub.
Como cito o Transcritório em um artigo ou tese?
Barbosa, R. J. (2026). Transcritório: transcrição local de entrevistas em português brasileiro (v0.2.8) [Software]. IESP-UERJ/CERES.
@software{barbosa2026transcritorio,
  author    = {Barbosa, Rog{\'e}rio Jer{\^o}nimo},
  title     = {Transcrit{\'o}rio: transcri{\c{c}}{\~a}o local de entrevistas em portugu{\^e}s brasileiro},
  year      = {2026},
  version   = {0.2.8},
  publisher = {IESP-UERJ/CERES},
  license   = {MIT},
  url       = {https://github.com/antrologos/Transcritorio}
}
Preciso de token da Hugging Face para os modelos?
Só se você quiser a separação automática de falantes: o modelo pyannote exige aceitar os termos de uso no site da Hugging Face (gratuito), e o assistente do primeiro uso guia o passo a passo. Para apenas transcrever, nenhuma conta ou token é necessário — escolha "apenas transcrever" no assistente.
Funciona com entrevistas em outros idiomas?
Sim. O foco é o português brasileiro, mas o Transcritório transcreve em 15 outros idiomas com tempos por palavra (espanhol, inglês, francês, alemão, italiano e outros — cada idioma baixa um pacote de alinhamento próprio), e um pacote multilíngue opcional (MMS, uso não-comercial) estende os tempos por palavra a mais de mil idiomas adicionais. A língua se escolhe por arquivo, na aba Propriedades.
A barra parece travada na "separação de falantes"?
Sem placa de vídeo, essa é a etapa demorada: de ~4 minutos (máquina de 24 threads) a ~22 minutos (4 threads) por hora de áudio (a transcrição em si leva minutos com o TAGARELA; com placa de vídeo a separação leva cerca de 1 minuto por hora). Desde a v0.2.3 a barra mostra o progresso real e uma estimativa de tempo — e, ao clicar em Transcrever, dá para desmarcar "Separar falantes agora": o texto fica pronto em minutos e a lista oferece completar as vozes depois, em lote.
Posso transcrever grupos focais com muitos participantes?
Sim, funciona bem até 6–8 falantes. Ao transcrever, escolha o preset "Grupo focal" quando o app perguntar quantas pessoas falam; na revisão, cada voz ganha uma cor, e o diálogo "De quem é esta voz?" toca amostras de cada participante para você nomeá-los. Acima disso, a separação começa a misturar vozes parecidas — revise os rótulos no editor.
O código é realmente aberto? Posso auditar?
Sim. Todo o código-fonte está publicado no GitHub sob licença MIT. Qualquer pessoa pode ler, modificar, redistribuir e verificar o comportamento do aplicativo.